
Dizionario Sonoro
Quasi tutto quello che serve sapere sull’audio – parte 1
Un viaggio in tutto l’audio con esperienze interattive che aiutano a capire, grafici, immagini e nessuna formula, non c’è la volontà di affrontare una montagna di argomenti fino in fondo ma solo quella di divulgare divertendosi con applicazioni interattive.
Detto questo, non sapevo come chiamare questo post dato che affronta veramente tanti argomenti, quindi ho pensato di farlo a capitoli e di chiamarlo Dizionario Sonoro che al momento è diviso in:
- Capitolo 1: Definizioni e nozioni base (questo post)
- Capitolo 2: La registrazione
- Capitolo 3: ? non lo so ancora ?
Sarà un post senza fine, per ora tanti argomenti sono “solo” accennati ma li porterò avanti a modo mio. Qui sotto trovate la comoda tavola dei contenuti che vi permette di navigare senza passare troppo tempo a cercare le varie cose.
Buon divertimento!
I Suoni e come li percepiamo
Il suono è un miracolo dell’atmosfera, noi percepiamo al 90% le frequenze dall’aria attraverso le nostre orecchie che ha un sensore “sensibile alle variazioni di pressione”, una minima parte arriva attraverso vibrazioni a bassa frequenza (spesso inudibile) che sentiamo tramite il nostro corpo.
Ogni animale, Homus Erectus compreso, sente i suoni nella maniera che l’evoluzione delle specie ha indicato. Noi siamo più sensibili nella zona del pianto dei bimbi ma è probabile che anticamente i nostri antenati erano più portati a sentire altre frequenze, quella degli altri predatori.
Il miagolio di un gatto ad esempio è un comportamento appreso per creare un ponte comunicativo, diverso da quello usato per minacce (soffi) o comunicazioni tra simili, ed è un facsimile del pianto dei bimbi umani e quindi per noi è un segnale di attenzione.
Per gli umani le frequenze coinvolte nei suoni vanno da 20 Hz a 20.000 Hz, valori che sono solo teorici perchè dipende dall’età delle persone e da tantissimi altri fattori, una persona anziana non sente sicuramente le frequenze oltre una certa soglia. A titolo personale, quando ero un ragazzo, riuscivo a sentire il generatore della frequenza di riga di alcuni televisori che era intorno a 16Khz e mi dava parecchio fastidio, ma ero quasi una mosca bianca perchè nessun altro percepiva questa cosa nel mio ambiente lavorativo, oggi è quasi certo che non lo percepirei più.
La Musica ad esempio è una emissione di suoni coordinati e strutturati ed è considerata la forma d’arte più diretta perchè non deve affrontare diverse “decodifiche” da parte del cervello come ad esempio le forme d’arte visive dove luci e colori vengono interpretati diversamente e la “visione periferica” allo stesso modo, nella musica è tutto più diretto.
Il nostro è un mondo rumoroso, non esiste il silenzio, mai. Il cervello discrimina quello che è il “rumore ambientale” e coglie solo quello che è “inusuale” per attivare il nostro livello di attenzione, ma dire che “voglio il silenzio assoluto” è un eufemismo, in realtà cerchiamo solo un “livello di rumore ambientale gradevole”.
Il silenzio assoluto esiste nelle “camere aneicoiche” e viene utilizzato per le misure acustiche e per la cura del “Tinnito” ma non auguro a nessuno di trovarsi da solo con il “rumore dei pensieri”, una persona sana in una camera aneicoica potrebbe sperimentare la pazzia, il cervello non è abituato e cercherebbe di ricostruire lui stesso dei rumori o peggio.
Livello e Volume
Sono la stessa cosa? No. Le onde sonore sono una caratteristica presente grazie all’atmosfera dato che vengono percepite dal nostro orecchio come cambio di pressione nell’aria, ovvero SPL (Sound Pressure Level). Su Marte ad esempio, il suono sarebbe molto attenuato dato che l’aria è rarefatta e la temperatura bassa, su Venere dove la temperatura al suolo è oltre i 400 Gradi e l’aria (che non è certo come la nostra!) ha una pressione molto elevata, il suono si trasmetterebbe per lunghi tratti.
Sotto, un semplice simulatore di come si sentirebbe il suono su diversi pianeti.
* TODO: Inserimento del nostro simulatore di suono su diversi pianeti
Pertanto, utilizziamo sempre il termine livello per descrivere l’entità del segnale, che si tratti di variazioni di pressione nell’aria, variazioni di tensione in un cavo di microfono o valori digitali memorizzati su un disco rigido, e volume per descrivere la nostra percezione dell’entità di quel segnale, ciò è necessario perché l’intensità del suono percepito dipende da molti fattori, distorsione, temperatura dell’aria, pressione, densità dell’aria (e quindi anche altitudine), umidità, etc. Lo standard di misurazione dei segnali audio è il decibel, I decibel esprimono sempre un rapporto tra due livelli, ad esempio un livello misurato e un livello di riferimento concordato, ad esempio, aggiungendo il suffisso “SPL” ci dice che viene utilizzato per rappresentare un livello assoluto riferito a 0 dB SPL. La scala in decibel non è lineare ma “logaritmica“, guardiamo questa tabella:
- +6 dB = 2 volte la pressione dell’aria o volts
- +20 dB = 10 volte la pressione dell’aria o volts
- +40 dB = 100 volte la pressione dell’aria o volts
- +60 dB = 1,000 volte la pressione dell’aria o volts
- +80 dB = 10,000 volte la pressione dell’aria o volts
Andando in negativo sui decibel si ottiene una sottrazione:
- –6 dB = 1/2 volte la pressione dell’aria o volts
- –20 dB = 1/10 volte la pressione dell’aria o volts
- –40 dB = 1/100 volte la pressione dell’aria o volts
- –60 dB = 1/1,000 volte la pressione dell’aria o volts
- –80 dB = 1/10,000 volte la pressione dell’aria o volts
Quindi, quando il livello di una sorgente acustica o di una tensione aumenta di un fattore 10, si tratta di un aumento di 20 dB, ma aumentare il livello originale di 100 volte aggiunge solo altri 20 dB e aumentare il livello originale di un fattore 1.000 aggiunge solo altri 20 dB.
Usare i decibel invece dei rapporti semplifica la descrizione e la notazione dell’intera gamma di livelli di segnale con cui lavoriamo nell’audio e la gamma di fluttuazioni della pressione sonora che possiamo percepire come suono, ad esempio, l’intervallo tra il suono più debole udibile e l’insorgenza di un dolore fisico estremo è di circa 140 dB. Se questa differenza di pressione fosse espressa utilizzando valori lineari normali (non logaritmici), l’intervallo verrebbe scritto come 10.000.000 a 1, il che sarebbe parecchio scomodo!
Le scale logaritmiche vengono utilizzate anche perché si relazionano meglio alla percezione uditiva umana. Un aumento di livello di 3 dB rappresenta un raddoppio della potenza, ma in genere suona solo leggermente più forte, per suonare il doppio del volume, il livello deve aumentare di circa 8/10 dB, a seconda di vari fattori, tra cui il livello iniziale e le frequenze presenti nella sorgente.
Alcuni dicono che la minima variazione di livello udibile è di 1 dB, altri dicono che è di 3 dB, in realtà, la minima variazione di livello che può essere notata dipende da diversi fattori, tra cui le frequenze presenti nella sorgente ma anche la distorsione.
Vale anche la pena menzionare la legge dell’inverso del quadrato. Quando il suono si irradia da una sorgente, diventa più debole con la distanza. Attenuazione delle frequenze sulla distanza:
- 125 Hz -> 0.3 dB/Km
- 250 Hz -> 1.1 dB/Km
- 500 Hz -> 2.8 dB/Km
- 1 kHz -> 5.0 dB/Km
- 2 kHz -> 9.0 dB/Km
- 8 kHz -> 76.6 dB/Km
Gli Standard
Come per i livelli acustici, anche il livello di un segnale audio in un filo o in un circuito elettrico è espresso in decibel, sia rispetto a un altro segnale sia rispetto a uno dei diversi livelli di riferimento standard comuni. Un amplificatore che raddoppia la sua tensione di ingresso si dice che abbia un guadagno di 6 dB. Questo aumento è lo stesso sia che la tensione in ingresso sia di 0,001 volt o di 5 volt; in ogni momento, la tensione in uscita è il doppio della tensione in ingresso. Ma, come per l’SPL, anche i dB vengono utilizzati per esprimere i livelli assoluti dei segnali elettronici utilizzando un riferimento scelto. Le metriche più comuni per esprimere i livelli assoluti del segnale nei dispositivi audio sono dBu, dBm, dBV e dBFS. La maggior parte delle apparecchiature audio professionali attualmente prodotte specifica i livelli di ingresso e uscita analogici in dBu, con 0 dBu corrispondente a 0,775 volt. Questa tensione apparentemente insolita non è arbitraria, poiché si riferisce al precedente standard dBm, descritto di seguito.
dBu
La “u” in dBu sta per “senza carico” (o, “senza terminazione“) perché i livelli non dipendono da una specifica impedenza di carico o da una terminazione, ma soprattutto per un motivo storico che risale all’epoca della prima telefonia. Livelli superiori a 0 dBu indicano tensioni superiori a 0,775 volt, mentre valori negativi in dBu indicano tensioni inferiori a 0,775 volt. Ad esempio, +20 dBu è dieci volte maggiore a 7,75 volt, e -10 dBu è circa un terzo a soli 0,245 volt. dBu descrive la tensione, indipendentemente dall’impedenza di ingresso e di uscita dei dispositivi collegati, 0 dBm è stato definito come pari a 1 milliwatt. La tensione richiesta per 1 mW di potenza attraverso un carico di 600 ohm è di 0,775 volt, che è l’origine del riferimento di 0,775 V per dBu.
dBm
La “m” in dBm sta per milliwatt, con 0 dBm pari a 1 milliwatt (millesimo di watt) di potenza. Il dBm è per lo più obsoleto.
dBv
Un altro standard è il dBv, dove la “v” sta per volt. I riferimenti al dBv sono meno comuni nei dispositivi professionali, ma a volte vengono utilizzati per l’elettronica di consumo, in questo standard, 0 dBV equivalgono a 1 volt, quindi per estensione +20 dBV equivalgono a 10 volt e –6 dBV equivalgono a mezzo volt.
dBFS
L’unità di misura dBFS (talvolta indicata come dB FS) è specifica dell’audio digitale, dove FS sta per “full scale“. Una volta digitalizzato un segnale audio, non è necessario alcun livello di tensione di riferimento o implicito. Qualunque sia la tensione di ingresso e di uscita per cui è calibrato il convertitore, 0 dBFS equivale al massimo livello digitale possibile prima dell’insorgenza di una distorsione grossolana.
RMS
Il valore efficace, o valore quadratico medio, RMS (Root Mean Square). Per segnali sinusoidali, l’RMS corrisponde a circa volte il valore di picco ed è particolarmente utile per calcolare la potenza poiché è possibile ignorare la polarità della tensione e la direzione della corrente. L’RMS non è un valore come il dBu ma la rappresentazione del suo valore efficace!
LKFS o LUFS
Nell’era moderna dell’audio digitale, si è evoluto uno standard di misurazione della sonorità più adatto, noto come LKFS o LUFS, che sta per loudness, K-weighted, relativo al fondo scala (come tutte le misurazioni digitali che pongono lo “zero” come limite invalicabile). Lo standard definisce il volume percepito dell’audio, non solo la sua ampiezza massima, normalizzando il suono su diverse piattaforme. Essenziali nel mastering, misurano la media (integrata) della dinamica; i target tipici sono -14 LUFS (Spotify/YouTube) e -16 LUFS (Apple Podcasts), puntando a un equilibrio tra potenza e dinamica.
- Integrated LUFS: La media del volume sull’intera durata, fondamentale per il mastering.
- Short-Term/Momentary: Misurano la loudness su brevi finestre temporali.
- Loudness Range (LRA): Valuta la variazione dinamica complessiva.
- True Peak: Indica il picco reale massimo per evitare distorsioni.
Target Comuni: Sebbene varino, -14 LUFS è lo standard di riferimento per molte piattaforme streaming, mentre podcast e parlato spesso mirano a -16 LUFS. Guerra del volume: Un valore LUFS troppo basso (es. -6 o -8) ottenuto con troppa compressione riduce la dinamica (differenza tra parti silenziose e forti) a favore di un volume costantemente alto. La misurazione LUFS (unità di misura della sonorità relative al fondo scala) è regolata dall’Unione Internazionale delle Telecomunicazioni (ITU) nello standard ITU-R BS.1770–5 e EBU R 128.
L’outsider dell’ultimo minuto.. Il Phon

Visto che per misurare l’audio non c’era abbastanza confusione, si sono inventati un’altra (inutile) unità di misura, il Phon, che non è quello per asciugare i capelli, bensì la misura del volume “percepito” e la vera utilità è proprio questa, differenziare l’intensità sonora dall’intensità percepita.
Il problema di fondo è che in Italiano esiste la parola “Intensità” che è utilizzata per indicare sia percezione che volume mentre in inglese ne esistono due diverse, ovvero, “Loudness” (per indicare il volume percepito) e “Intensity” per l’intensità, quindi confusione… Ad ogni modo personalmente uso la parola Phon solo quando “dovevo” asciugarmi i capelli (purtroppo, non ci sono più)
Nota: Il file a sinistra è di Carlo Andrea Rozzi
* TO-DO: Argomento da terminare…
Mono, Stereo, Mid/Side, Quadrifonico, Binaurale, 6/1, 7/1, etc…
Polarità
Un concetto fondamentale prima di iniziare a parlare di canali, lavorando elettricamente il segnale può avere una fase ma se da solo il fatto non è determinante, comincia ad avere una importanza quando viene messo assieme ad altri segnali!
Il simbolo della fase è il “fi”, lo zero barrato, o phi, Ø. Vedremo qui sotto perchè è importante la “fase” e come interreagisce con gli altri segnali.
* NOTA – Dimostrazione fase (ToDo)
L’illusione dello stereo
La localizzazione è non del tutto precisa in quanto abbiamo solo due orecchie e funziona in questo modo:
- Differenza di volume
- Differenza temporale
- Ambedue
Il suono degrada di intensità e contenuto spettrale man mano che procede nello spazio, potremmo chiamarlo “attrito” sonoro e il nostro cervello percepisce la differenza temporale e il volume per identificare il punto di emissione.
Ma la lunghezza d’onda delle frequenze basse è molto più grande di quelle alte, parliamo di metri, 100Hz ad esempio sono 3,55 metri! Le frequenze basse sono così grandi che la nostra testa non ne percepisce la direzione perchè è troppo piccola e viene “avvolta” da queste frequenze. (link per un calcolatore online), quindi la percezione dello stereo è vera per alcune frequenze in particolare, le altre le sentiamo in mono, con delle eccezioni che sono ovvie, un suono basso in cuffia ad esempio, o diretto ravvicinato ad un orecchio (cosa non consigliabile!), va ricordato che TUTTE le frequenze viaggiano alla stessa velocità.
Quindi, l’unico modo che abbiamo per localizzare le frequenze basse è la differenza temporale e non la variazione di volume.
Il Pan Pot, o Bilanciamento, è un sistema che influisce solo sulla differenza di volume. Se mettiamo un suono al centro tra due casse e chiudiamo gli occhi, avremo l’illusione che il suono arriva dal centro dove in effetti non c’è alcuna fonte sonora, l’effetto si chiama “Centro Fantasma” ed è di fatto una illusione, quindi, se i suoni provenienti da due casse tipicamente in un angolo dai 20° ai 70° (la tipica disposizione dello stereo) hanno lo stesso volume avremo l’illusione che il suono arrivi dal centro e viene chiamato “phantom center”.
Il Pan Pot o Bilanciamento cambia la posizione di questo centro.
Lo standard dei canali
Benchè possessori di 2 orecchie (e talvolta solo una!) il suono può avere una sua “spazialità” che può essere generata in vari modi:
- Mono: una cassa e via!
- Stereo: due casse (e l’intervento delle riflessioni più o meno presenti della stanza). Con l’avvento dello stereo arriva un nuovo controllo “consumer”, il Bilanciamento, che nel Professionale diventa Pan (da Panorama).
- Binaurale: In realtà non parliamo del vero “binaurale” che è una codifica di cui si parla più avanti ma di un sistema che tramite appositi processori (o DSP) rendono il suono più immersivo, basato ancora una volta su una tecnica microfonica e originalmente da una “testa artificiale”, se ne parlerà nella sezione dedicata alla registrazione, più avanti. La tecnica Binaurale può essere considerata una versione “immersiva” dello stereo e usa due casse come quest’ultimo (o una cuffia).
- Quadrifonico: In realtà parliamo di un estinto di vecchia data, anni 70, la codifica SQ, etc. Usata in alcuni vinili e ovviamente diventata una rarità.
- Multicanale o Surround: i vari 5/1, 5/1, 7/1, etc. Il primo numero sono le “casse acustiche coinvolte”, il secondo è il canale “subwoofer” per la bassissime frequenze che per questioni di larghezza d’onda non hanno direzionalità quindi possono essere incanalate anche in mono.
- Immersivo: Wikipedia lo identifica erroneamente nell’audio surround ma il suono immersivo lavora con il concetto di “punti sonori”, tutti uguali e sparsi. Prima su tutti, il Dolby Atmos, molto pubblicizzato per la possibilità di poter essere decodificato anche con un normale stereo, pure dal telefono, prospettiva notevole ma di fatto piuttosto “falsa”. Atmos è un sistema composto da diversi altoparlanti, solitamente tutti eguali, che possono arrivare anche a quantità di due o tre zeri (!), più sono, più il sistema diventa ideale… Di fatto molto usato nei cinema e nei videogiochi (probabilmente per una prospettiva futura di allungargli la vita in un futuro ipotetico).
Nota: Non vengono prese in considerazione le cuffie perchè rientrano comunque nei sistemi di ascolto sopra citati (e in modi acustici e digitali)
Dal Quadrafonico in poi, multicanale compreso, i sistemi “consumer” hanno faticato a digerirli, costi, difficoltà di posizionare casse e cavi, problemi legati al rumore e alla configurazione delle stanze con porte e finestre, non tutti hanno a disposizione una sala di ascolto o cinema in casa!
Con Atmos, la Dolby ha giocato la carta della “flessibilità”, in un cinema tante casse uguali, anche in soffitto. In casa, molte meno, possibilmente anche sul soffitto (è un sistema chiamato “puntiforme”), ma per non perdere utenti ha creato un decodificatore che lavora teoricamente anche con due sole casse o addirittura con il cellulare (dove la risposta in frequenza e la disposizione dei “nano” altoparlanti è ridicola), di fatto il sistema restituisce solo un suono “strano” e non ha nessun risultato “spaziale”, anzi, non conosco nessun professionista o collega che lo abbia usato senza staccarlo un minuto dopo!
Ok, manca all’appello il MID/SIDE…
Beh, presto detto, non è usato per l’ascolto, non è presente negli impianti stereo, nè sui telefonini… Si tratta di un sistema di “codifica” equivalente allo STEREO normalissimo va visto in un altro modo.
MID/SIDE significa proprio questo, la “parte in mezzo”, mono ovviamente e la parte “stereo”, senza la parte in mezzo, anche questo ovvio!
La parte MID si ottiene sommando il canale sinistro e quello destro assieme e rappresenta la parte “centrale del segnale“. (abbassato di -3dB o -6dB)
La parte SIDE si ottiene sommando i due canali sinistro e destro ma con il destro invertito di fase. Il risultato è sinistro-sestro e rappresenta la “spazialità o profondità stereo“
La versione originale è di due canali mono ed è nata assieme allo stereo, tantissimi anni fa, originalmente prevista per un metodo di registrazione chiamato appunto MS che con soli due canali permetteva più flessibilità potendo manipolare la parte centrale dalla parte spaziale separatamente.
Alcuni algoritmi di compressione “loseless” come il FLAC usano la codifica M/S per risparmiare “bit di calcolo” preservando correttamente le informazioni, cosa che non fa il sistema MP3 che si affida alla FFT.
Questa versione non può essere utilizzata in ascolto perchè necessita di essere decodificata, ovvero, la parte stereo va estrapolata in questo modo:
- Canale Sinistro: MID + SIDE
- Canale Destro: MID – SIDE
La versione moderna usa sempre due canali ma la parte “SIDE” è realmente stereo, a differenza della codifica originale che necessita di essere alla fine “decodificata”, sommando il MID al SIDE (versione moderna) si ha come primo vantaggio il fatto di poter ascoltare correttamente il segnale originale.
Oggi, moltissimi plugin hanno internamente la possibilità di lavorare internamente sia in stereo che in MS (moderno) e questo semplifica notevolmente la vita a chi li usa perche questa codifica non è sempre utilizzabile con buoni risultati!
Cosa c’è nella parte MID ?
Ovviamente tutto quello che è al centro dell’immagine stereo, ovvero la cassa, il basso, la voce e tante altre cose come la parte centrale del pianoforte, parti della batteria…
Cosa c’è nella parte SIDE?
Non pensate al SIDE come allo stero, piuttosto è la parte “spaziale” dell’immagine stereo! Di solito strumenti posizionati distintamente a destra o a sinistra, tanti parte alte, gli ambienti e i reverberi applicati alla voce.
Utilizzi
Il primo è stata la codifica e decodifica di un sistema di registrazione basato su due microfoni ma negli anni 90 è stato riscoperto dal mastering che lo ha usato (e abusato), tuttavia spesso può tornare realmente utile, come ad esempio la parte bassa di un brano poco presente può essere manipolata dal MID, la presenza della cassa, sempre dal MID e grazie a questo l’impatto sull’intero spettro sonoro de file è minimo, ma si possono correggere diverse cose anche dalla parte SIDE comel’aumento dell’immagine stereo, la correzione (parziale) del posizionamento nell’immagine stereo di qualche strumento o l’uso di DeEsser dato che solitamente il SIDE è la casa di molte parti con alte frequenze.
Fortunatamente oggi si può sfruttare la parte M/S incorporata in tanti PlugIn audio (come i FabFilter) senza imbarcarsi in un flow M/S che nonostante i vantaggi presenta delle criticità che spessissimo non vengono nemmeno prese in considerazione da valenti e blasonati fonici, ne caso del “mastering”, ad esempio:
- Quando si usano le catene di effetti separate, nessun DAW garantisce il perfetto allineamento di fase e tempo con i plugin terze parti inseriti, ergo, ricombinando il segnale in stereo possono verificarsi problemi di vario tipo come phasing, flanging, abbassamento di alcuni strumenti, etc.
- In caso si usi due tracce, MAI inserire un ausiliario perchè non sono compensati dei ritardi!
- Occhio che il SIDE non deve essere carico di basse frequenze, ci sono plug che non le trovano e le compensano alzandole ma non è certo questo il caso, tranne qualche eccezione di solito le frequenze sotto gli 80 Hz non devono esserci nel SIDE.
- Qualsiasi cosa che faccia scherzi di modifica della fase (anche parziale) come EQ non a FASE LINEARE alla fine del processo possono riservare brutte sorprese, come strumenti che si abbassano inspiegabilmente, un esempio classico e la cassa/basso che tendono a sparire.
Questo è il test per lo stereo:
Ora le versioni MID/SIDE (MS) dello stesso brano nei due formati, iniziando da quello classico con due file audio mono (encoded MS):
Encoded MID
Encoded SIDE
La versione moderna in formato mono per il MID e stereo per il SIDE. Ricordo che il vantaggio di questa versione è quella di essere immediatamente utilizzabile suonando ambedue i file mentre la versione classica necessita di decodifica.
Inline MID
Inline SIDE
Frequenze
Come per il livello, anche le frequenze vengono percepite e spesso espresse in modo logaritmico. La parola “frequenza” indica “oscillazione in un dato periodo” ed è un termine usato per definire.
Le frequenze nell’audio sono spesso correlate alle note, alzare l’altezza di una nota di un’ottava equivale a raddoppiarne la frequenza, mentre abbassarla di un’ottava dimezza la frequenza.
Per una nota La a 440 Hz, l’altezza potrebbe dover essere spostata di 5-10 Hz prima che venga percepita come stonata, ma la nota La a 1.760 Hz, due ottave più in alto, dovrebbe essere spostata di 20-40 Hz prima di accorgersi che è stonata.
Quasi nessuno strumento musicale offre solo “fondamentali” ma anche gli “Overtones” che vengono chiamati Armonici o Parziali.
Lunghezza d’onda
La Lunghezza d’Onda è il risultato facendo la divisione della velocità del suono con la frequenza. La velocità del suono è di 344 metri al secondo (a 21° centigradi) ma bisogna dire che dipende dat tanti altri fattori come la densità dell’aria (quindi altitudine e umidità).
Ad ogni modo le temperature non influiscono enormemente come gli altri fattori per cui viene utilizzata come valore 344.
Il simbolo della lunghezza d’onda è “lambda”, una specie di y rovesciata λ.
Il grafico di una risposta in frequenza può essere considerato Semi-Log perchè solo una delle scale è logaritmica, altrimenti esiste la scala log-log
| Frequenza | Peculiarità | |
| 16Hz | ||
| 20Hz | ||
| 25Hz | Limite Basse | |
| 31.5Hz | ||
| 40Hz | ||
| 50Hz | Bump della cassa | |
| 63Hz | ||
| 80Hz | Floor Tom | |
| 100Hz | Toms | |
| 125Hz | Basso | |
| 160Hz | ||
| 200Hz | ||
| 250Hz | ||
| 315Hz | Ris. Chitarra Ac. | |
| 400Hz | ||
| 500Hz | ||
| 630Hz | ||
| 800Hz | ||
| 1Khz | Ris. Voce | |
| 1.25KHz | ||
| 1.6KHz | ||
| 2KHz | ||
| 2.5Khz | ||
| 3.15Khz | ||
| 4KHz | ||
| 5KHz | ||
| 6.3KHz | ||
| 8KHz | Armoniche HiHat | |
| 10KHz | ||
| 12.5KHz | ||
| 16KHz | Limite alto | |
| 20KHz |
Il grafico a lato è a Terzi di Ottava e in verde è indicata la scala ad ottave
Notate che nessuna frequenza indicata è correlata a note, il grafico a “terzi di ottava” è universalmente usato per districarsi all’interno di gruppi di frequenze e non è correlato direttamente alla musica ma al suono emesso.
Le parti colorate sulla destra indicano le zone di influenza :
- Infrabasse
- Basse
- Medio Basse
- Medie
- Alte
- Iper alte
Gli analizzatori di spettro oggi presenti in qualsiasi DAW un tempo erano prerogativa degli studi di registrazione ed erano molto costosi dato che erano costruiti con 32 filtri con una pendenza equidistante e precisa e ovviamente uno per singola frequenza (come da tabella a lato), L’uscita del filtro veniva convertita in tensione e usata per muovere una linea di led o in certi casi una barra su uno schermo.
Oggigiorno si usa la FFT (vedi più avanti) e la potenza di calcolo delle CPU è tale che è una operazione basica e per nulla costosa.
Frequenze TEST utili:
Le frequenze sono state generate elettronicamente a bassissima distorsione e sono a disposizione per i vostri test.
Sinusoidi, 16Bit, WAVE
Sine, -10dB, 16bit, sinistro
Sine, -10dB, 16bit, stereo
Sine, -10dB, 16bit, destro
24bit Sweep mono (ATTENZIONE al volume!)
24bit Sweep stereo (ATTENZIONE al volume!)
32bit Sweep stereo (ATTENZIONE al volume!)
Sine, -10dB, 24bit, stereo
Sine, -10dB, 32bit, stereo
Tipi di filtri
Sotto, una lista di filtri, i più comuni.
Ne esistono tantissimi, molti prendono il nome di chi per primo li ha costruiti ma in generale si dividono in Analogici e Digitali.
I primi sono molto amati per la loro “musicalità”, ma purtroppo nel mondo reale non possono fare cose che solo i filtri digitali possono fare, come avere un impatto minimo sulla fase o i particolari filtri FIR usati nelle correzioni acustiche.
Una caratteristica importante da tenere sempre in considerazione è la “linearità di fase”, ovvero, la capacità del filtro di non avere alcun impatto sulla fase (prerogativa dei filtri digitali)

Filtro Passa-Basso (Low-Pass Filter)
Permette il passaggio delle frequenze al di sotto di una determinata “frequenza di taglio” e attenua quelle superiori. È utile per rimuovere rumori ad alta frequenza o per indirizzare i segnali ai woofer in un crossover audio.
Il Filtro Passa Basso è anche uno dei protagonisti assoluti della sintesi sottrattiva, quella dei Moog per intenderci, il famoso “ladder”, caratterizzato da una pendenza di 24 db/oct (a volte 12), frequenza di taglio controllabile tramite tensione e un valore “nuovo” chiamato “risonanza” che è caratteristico di ogni costruttore, in certi casi al massimo può oscillare e creare una distorsione di intermodulazione con il suono da filtrare oltre che a poter essere controllato sempre da una tensione.
NOTA:
Questo tipo di filtro, molto usato, ha un impatto sulla fase molto importante tale da creare, in ceri casi, una totale inversione. Nel caso di filtri digitali a “fase lineare” non sussiste alcun problema ma solo un uso maggiore delle risorse ma nel caso di filtri analogici potrebbe essere un problema enorme.
Caratteristiche e valori:
- Pendenza: Quanto “attenua” espresso in db/oct
- Taglio; Frequenza da dove il suono viene tagliato, in Hz
- alt: Risonanza: Caratteristica presente su alcune tastiere, sul punto della frequenza di taglio, amplifica con una pendenza che può arrivare alla oscillazione.
Un esempio di filtro Low Pass in stle sintetizzatore, con due cursori, quello in alto è il Q (o risonanza), quello in basso è il taglio (frequenza)
TOP

Filtro Passa-Alto (High-Pass Filter)
Permette il passaggio delle frequenze al di sopra di una “frequenza di taglio” e attenua quelle inferiori. Viene spesso usato per eliminare rimbombi o rumori di fondo a bassa frequenza, o per indirizzare i segnali ai tweeter.
Anche questo filtro ha una variazione dovuta al retaggio dei sintetizzatori analogici a sintesi sottrattiva degli anni 70/80, vale come il filtro passa basso (vedi sopra), anche se meno usato.
NOTA:
Questo tipo di filtro, molto usato, ha un impatto sulla fase molto importante tale da creare, in ceri casi, una totale inversione. Nel caso di filtri digitali a “fase lineare” non sussiste alcun problema ma solo un uso maggiore delle risorse ma nel caso di filtri analogici potrebbe essere un problema enorme, ad esempio filtrare una Cassa e/o un Basso, uno dei due potrebbe letteralmente andare fuori fase e abbassarsi.
Caratteristiche e valori:
- Pendenza: Quanto “attenua” espresso in db/oct
- Taglio; Frequenza da dove il suono viene tagliato, in Hz
- alt: Risonanza: Raro, è una caratteristica speciale del Passa Basso, raramente si vede su questo filtro.
L’Hi Pass ha solo la regolazione della frequenza di taglio.
TOP

Filtro Passa-Banda (Band-Pass Filter)
Permette il passaggio delle frequenze all’interno di un intervallo (banda passante) e attenua quelle al di fuori. In parole povere è un filtro Passa Basso + un filtro Passa Alto.
Tra i sintetizzatori c’è chi alla fine degli anni 80 decise di avere questa possibilità unendo un passa basso e un passa alto (e mantenendone tutti i controlli a parte la campana centrale delle due frequenze di taglio), l’ELKA Syntex
Il classico filtro “passabanda” in versione normale.
TOP

Filtro Elimina-Banda (Band-Stop Filter o Notch Filter)
Attenua le frequenze all’interno di una specifica banda e lascia passare quelle al di fuori, l’opposto del filtro Passa Banda Il filtro notch è una versione con una banda molto stretta, spesso usata per rimuovere ronzii specifici, come quello a 50/60 Hz della rete elettrica.
TOP

Filtro Passa-Tutto (All-Pass Filter)
Lascia passare tutte le frequenze allo stesso modo (non modifica la risposta in ampiezza), ma altera le relazioni di fase tra le varie frequenze. Viene utilizzato per correggere la fase senza modificare il tono.
TOP
Filtro Shelving (Shelf EQ)
Aumenta o diminuisce uniformemente le frequenze al di sopra (high shelf) o al di sotto (low shelf) di una frequenza specifica, creando una sorta di “piattaforma” (shelf) nella risposta in frequenza. Molti controlli di tono degli amplificatori HiFi sono di questo tipo
TOP

Filtro Peaking (Peaking EQ o Bell EQ)
Crea un aumento o una diminuzione a forma di campana attorno a una frequenza centrale specifica. La larghezza della banda interessata è definita dal parametro “Q”.
TOP

Comb Filter (o filtro a pettine)
Può essere + o –. E’ un filtro digitale che crea una serie di picchi e minimi periodici nella risposta in frequenza (che ricordano i denti di un pettine), solitamente identificato a “poli” i quali sono ritardati uno dall’altro. Viene utilizzato in effetti sonori come riverbero e flanger (dove viene usata la versione Comb – e i “poli” vengono modulati singolarmente o tutti assieme).
Il filtro COMB è essenziale per il sound design, ad esempio, due copie dello stesso suono, se una viene spostata da 0.1 a 20 ms produce una serie di cancellazioni di fasi periodiche e boost, tipiche dei filtri COMBI.
TOP
Filtro “Vowel”
Il filtro Vowel è una via di mezzo tra un filtro comb e uno a pettine ma i picchi sono specifici e di solito tarati sulle “vocali dell’amore”, ovvero, Ah Eh Ih Oh Uh!
Non è una novità ma frutto di tentativi di ricostruire la voce umana, negli anni 70 alcune tastiere “violini”, tipo il Solina, li usavano per questo scopo ed erano fatti con diverse bobine data la difficoltà di progettazione/realizzazione. Solo con l’avvento dei circuiti moderni è stato possibile ricrearli facilmente e con i DSP ancora di più. Oggi sono presenti ovunque anche se non vengono utilizzati troppo spesso.
Una versione approssimativa è il Wah Wah, il pedale della chitarra.
TOP

FIR Filter
Un filtro FIR (Finite Impulse Response, o “risposta all’impulso finita”) è un tipo di filtro digitale che non utilizza feedback (non è ricorsivo) e la cui risposta a un impulso di ingresso termina dopo un numero finito di campioni.
- Non Ricorsivo: La sua uscita in un dato istante dipende solo dai campioni di ingresso correnti e passati, non da valori di uscita precedenti.
- Stabilità Intrinsica: I filtri FIR sono sempre stabili, a differenza di alcuni filtri IIR (Infinite Impulse Response) che possono diventare instabili.
- Fase Lineare: Possono essere progettati per avere una risposta in fase perfettamente lineare, il che significa che non introducono distorsioni di fase nel segnale (tutte le frequenze vengono ritardate uniformemente). Questa caratteristica è molto apprezzata nell’elaborazione audio, come nei processori RCF FiRPHASE.
Non esistono filtri FIR analogici, per loro natura sono prettamente digitali e sono molto usati nella correzione ambientale
TOP

Filtro Gaussiano
Un filtro audio Gaussiano è un tipo di filtro la cui risposta all’impulso ha la forma di una curva di Gauss (la classica “campana”). In ambito audio, è principalmente un filtro passa-basso utilizzato per ammorbidire il segnale e ridurre il rumore ad alta frequenza senza introdurre artefatti indesiderati, viene considerato un filtro FIR.
- Assenza di “Ringing”: A differenza di molti altri filtri digitali, il filtro Gaussiano non produce oscillazioni (overshoot) in risposta a cambiamenti bruschi del segnale, garantendo una transizione molto naturale.
- Ritardo di Gruppo Minimo: È caratterizzato dal minor ritardo di gruppo possibile, il che lo rende ideale per mantenere la coerenza temporale del segnale.
- Smoothing Naturale: Agisce come un operatore di “sfocatura” (blurring) sonora, rendendo l’attacco dei suoni meno netto e più avvolgente.
I filtri Gaussiani sono sempre di natura digitale e vengono usati nei riduttori di rumore, attenuazione delle armoniche indesiderate.
TOP
Con l’applicativo sopra potrete sperimentare tantissimi filtri digitali anche su audio in vostro possesso, i parametri sono tanti e viene correttamente mostrata la polarizzazione.
Buon divertimento!
Filtri Digitali
Come si usa:
* argomento da scrivere
Risonanza e Smorzamento
La risonanza è un concetto importante in ambito audio perché spesso migliora la qualità percepita degli strumenti musicali, ma ne compromette la riproduzione quando si verifica nei circuiti elettronici, negli altoparlanti e nelle sale d’ascolto. Con un violino, le frequenze di risonanza sono costanti, ma con un clarinetto o un flauto, la risonanza interna della canna dipende da quale delle varie dita è aperta o chiusa. Le principali differenze tra un violino economico e uno Stradivari sono il numero, la forza, il Q e la frequenza delle loro risonanze naturali. Un parente stretto della risonanza è lo smorzamento, generalmente causato dall’attrito che converte parte dell’energia del movimento in calore. Negli altoparlanti ad esempio, risonanza tende a essere più forte e dannosa con altoparlanti più grandi usati come woofer perché hanno una massa molto maggiore rispetto ai coni piccoli e leggeri dei tipici driver per tweeter.
* TO-DO: Argomento ancora da scrivere
Distorsione
Personalmente, preferisco riservare il termine “distorsione” ai casi in cui la non linearità crea nuove frequenze non presenti nell’originale. Nonostante la distorsione ad alcuni incute “timore”, in realtà è spesso correlata a “cose che suonano bene”, come nell’HiFi dove la distorsione armonica (che vediamo tra poco) delle valvole arricchisce il suono e lo rende più pieno e imponente. Nel mondo professionale della registrazione e nella musica la distorsione è spesso una amica, pensate alle chitarre elettriche, al suono di una batteria (che bene o male è piena di distorsioni dovute a mille cose), a generi di musica dove viene usata massicciamente e in modo creativo. I due tipi fondamentali di distorsione sono l’armonica e l’intermodulazione, ed entrambe sono quasi sempre presenti insieme. Anche la distorsione è logaritmica ma quasi sempre viene misurata in percentuale, ecco una tabella che indica il valore in dB
- 10% distorsione=−20 dB
- 1% distorsione=−40 dB
- 0.1% distorsione=−60 dB
- 0.01% distorsione=−80 dB
- 0.001% distorsione=−100 dB
Distorsione Armonica La distorsione armonica aggiunge nuove frequenze che sono musicalmente correlate alla sorgente. Questo tipo di distorsione viene recepita solitamente in maniera positiva dato che il segnale si “arricchisce” e non viene snaturato.
Distorsione di Intermodulazione La distorsione da intermodulazione (IMD) richiede la presenza di due o più frequenze, ed è molto più dannosa a livello uditivo della distorsione armonica perché crea nuove frequenze di somma e differenza che non sono sempre musicalmente correlate alle frequenze originali. Ad esempio, due frequenze, un La è un Do#, rispettivamente 440Hz e 277Hz
- Somma: 440Hz 277Hz -> 717Hz (stonata)
- Differenza: 440Hz 277Hz -> 163Hz (stonata)
Danno origine grazie alla somma e differenza ad altre due note che sono stonate e quindi la senzazione auditiva non sarà delle migliori, ovviamente più è alta la distorsione e più + evidente
La distorsione da intermodulazione transitoria (TIM) è un tipo specifico di distorsione che si manifesta solo in presenza di transienti, ovvero suoni che aumentano rapidamente di volume, come rullanti, legni, clave o altri strumenti a percussione (come la batteria) e dato che interviene in un lasso di tempo specifico spesso è voluta per aumentare le armoniche a strumenti che non sempre sono “tonali”.
Distorsione correlata all’Audio Digitale Anche l’audio digitale ha le sue distorsioni specifiche che verranno affrontate nel capitolo seguente.
Un esempio di come percepiamo la distorsione noi umani…
La playlist sotto mostra diversi file che hanno in comune la stessa frequenza (125Hz), la stessa forma d’onda (ovviamente sinosuidale, per poter percepire la distorsione!) e lo stesso livello (-6db).
Unica differenza è il livello di distorsione che parte da 0.005% e arriva al 5%. Provare per credere, percepirete appena la distorsione solo all’1% (se siete fortunati) ma attenzione, si tratta di una sinusoide, in un segnale complesso come musica la distorsione all’1% potrebbe tranquilla mente essere percepita positivamente (ergo, il file suona meglio!)
* TO-DO: Argomento da completare
Oscillatori e forme d’onda
Capire gli oscillatori è importante perchè il suono è fatto di oscillatori naturali o sintetici.
Click per l’analisi di spettro…

Sinosuidale
La frequenza sinosuidale non ha armoniche, in laboratorio viene infatti usata per misurare la distorsione; un oscillatore sinosuidale senza difetti (di conseguenza molto costoso) viene usato per testare una apparecchiatura audio che la riproduce con l’aggiunta di eventuali distorsioni. Il segnale risultante viene filtrato dal segnale sinosuidale originale con un filtro ad alta pendenza (costoso pure lui), quello che rimane è la distorsione. Le fonti “sinosuidali” sono tantissime ma veramente poche prive di distorsione, il Rhodes ad esempio, l’Hammond (usando un solo Drawbar), molti strumenti a fiato (anche se sono contaminati da vibrazioni e rumore bianco). In musica elettronica non è raro ricavare una sinusoide da una forma d’onda triangolare (che è più facile da creare), basta filtrarla, fare l’opposto è più difficile. La caratteristica della forma d’onda sinusuidale è:
- Assenza di armoniche
- Simmetrica
Onda Sinosuidale con Oscilloscopio
Onda Sinosuidale con Analizzatore
Click per l’analisi di spettro…

Triangolare
La caratteristica della forma d’onda Triangolare è:
- Armoniche Dispari
- Simmetrica
Onda Triangolare con Oscilloscopio
Onda Triangolare con Analizzatore
Click per l’analisi di spettro…

Dente di sega
Le caratteristiche della forma d’onda Dente di sega sono:
- Armoniche Pari e Dispari
- Asimmetrica
Tutte le forme d’onda asimmetriche producono armoniche sia pari che dispari
Onda Dente di Sega con Oscilloscopio
Onda Dente di Sega con Analizzatore
Click per l’analisi di spettro…

Quadra
Le caratteristiche della forma d’onda Quadra sono:
- Armoniche Pari e Dispari
- Duty Cycle variabile
L’onda quadra è quella che produce più armoniche e viene spesso utilizzata nelle misure audio proprio per la sua caratteristica forma. Viene inserita in una apparecchiatura audio e visualizzando la forma d’onda si notano possibili difetti, tipo la parte sinistra esaltata indica un aumento delle basse frequenze, l’opposto indica la stessa cosa per le alte, un picco su uno dei fronti di salita della forma d’onda indicano difetti nella velocità e csì via. La forma d’onda quadra è per sua natura la regina in campo digitale, il “clock” ad esempio è una onda quadra.

Una delle sue caratteristiche è la possibilità di cambiare il “Duty Cycle”, ovvero la simmetria Questo cambia radicalmente il contenuto delle armoniche che si sbilanciano tra Pari e Dispari secondo lo “schiacciamento” a destra o sinistra della forma d’onda quadra originale.
Onda Quadra con Oscilloscopio
Onda Quadra con Analizzatore
Click per l’analisi di spettro…

Rumore Bianco
Le caratteristiche del Rumore Bianco sono:
- Contiene TUTTE le frequenze
Dato che all’interno del rumore bianco ci sono tutte le frequenze nello stesso momento, nelle analisi audio è molto usato perchè è facile avere un’idea della risposta in frequenza di apparecchiature ma anche di grossi impianti audio come concerti, etc. In natura il rumore bianco è ovunque ed è quasi sempre presente come “rumore ambientale”, oppure nel vento, nei boschi (le foglie sommandosi lo producono). Bisogna considerare che esistono diversi diti di questo rumore e prendono nome dai colori:
- Bianco: Stessa energia su tutte le frequenze
- Rosa: Più energia sulle basse frequenze, decremento di 3dB ogni volta che una frequenza raddoppia
- Rosso o Marrone: detto anche Browniano, decremento di 6dB ogni volta che una frequenza raddoppia
- Blu: Complementare al rumore Rosa, più energia alle alte frequenze e incremento di 3dB ogni volta che una frequenza raddoppia
- Viola: Complementare al rumore Rosso, più energia alle alte frequenze e incremento di 6dB ogni volta che una frequenza raddoppia
- Gaussiano (rumore statistico): Densità di probabilità uguale a quella della distribuzione normale. Questo tipo di rumore è caratterizzato dalla sua curva a campana, che è simmetrica attorno al valore medio
Click per l’analisi di spettro…
Impulso
oh oh… Abbiamo un “intruso”!
https://it.wikipedia.org/wiki/Risposta_impulsiva
- TO-DO: Da completare
Sperimentate voi stessi con questa applicazione interattiva!
FFT
La Trasformata di Fourier Discreta (DFT) è un algoritmo matematico essenziale che converte un segnale dal dominio del tempo (dove si osserva l’ampiezza variare nel tempo) al dominio della frequenza (dove si vedono le singole componenti spettrali che lo compongono). la “Fast Fourier Transform” è una versione velocizzata dello stesso algoritmo (decine di migliaia di volte più veloce) ed è ovviamente la versione più utilizzata! Per chi vuole investigare a livello matematico consiglio questa pagina.

Con la trasformata di Fourier è possibile scomporre qualsiasi forma d’onda anche complessa in una serie “n” di sinusoidi, quindi è perfetta per analisi spettrali. Ma è anche possibile l’opposto, ovvero, ricostruire una forma d’onda complessa usando “n” sinusoidi, ovviamente più sono meglio è. Nella figura a fianco una serie di esempi: A sinistra è una ricostruzione di una forma d’onda quadra partendo da 8 sinusoidi che si sommano una con l’altra.

A sinistra la ricostruzione di un’onda triangolare partendo da 8 sinusoidi che si sommano l’un l’altra
Audio Digitale
L’audio è fatto di vibrazioni nell’aria, ma i computers lavorano con sequenze di 0/1, per poter passare dal mondo del segnale analogico a quello digitale serve una conversione Analogica->Digitale e di conseguenza per tornare nel mondo analogico da quello digitale serve una conversione Digitale->Analogica.
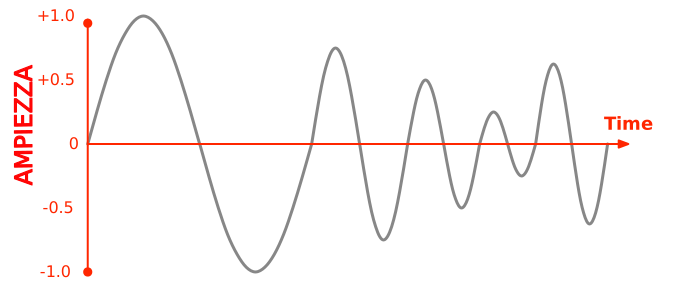
Conversione Analogico->Digitale
Prendiamo come riferimento questo segnale a sinistra, mettiamo che sia 1 secondo di materiale audio che dobbiamo convertire.
L’unico modo per portare un segnale analogico nel mondo digitale è “digitalizzarlo“, ovvero, tagliare a fettine il nostro 1 secondo di riferimento, diciamo in 44100 pezzettini e misurare per ogni pezzo il valore in modo da ridurre il tutto in numeri. La frequenza di questo “spezzettamento” viene chiamata “frequenza di campionamento“, ecco perchè in questo caso si dice 44.1Khz/Sec.
Per misurare i singoli valori abbiamo bisogno di una unità di misura, ovvero i “bit”, per questo il secondo valore fondamentale nella conversione analogica è il “Bit Deph“, ovvero, profondità di bit.

Cosa avviene nella conversione
Il segnale è ovviamente una tensione, per comodità l’ampiezza la consideriamo in Volt positivi e negativi (anche i convertitori lavorano a tensioni molto più basse, giusto per essere precisi).
Le linee verticali rappresentano la “segmentazione” che abbiamo nominato prima (44100Hz), se convertissimo con una profondità di 8bit, avremmo 256 valori massimi, ma c’è un’asse orizzontale perchè il nostro segnale scende anche in negativo, quindi i nostri valori ad 8 bit saranno +127 (parte positiva), 0 e -127 (parte negativa).
La misura viene effettuata per ogni singolo “pezzettino” del nostro clock e i valori vengono messi in fila. Il computer sa esattamente cosa sono dato che ha i dati fondamentali per poter gestire questi dati che ora sono in formato “trenino con 44100 vagoni, di cui ogni vagone ha 8 passeggeri (bit)”
I valori dati sono fittizzi e non corrispondono alla realtà ma comunque da l’idea di quello che succede in realtà. Il trucco è che il tutto avviene a velocità molto elevate dato che i computer non hanno problemi a riguardo, in passato non era possibile arrivare a velocità accettabili ed è per questo che l’audio digitale si è sviluppato solo quando le risorse lo permettevano.
Un tipico filtro di ingresso deve passare dal passaggio completo a 20 kHz al blocco completo a 22 kHz e oltre; ciò richiede un filtro con una pendenza di roll-off superiore a 80 dB per ottava.
Sebbene 16 bit offrano un livello di rumore sufficientemente basso per quasi tutte le attività di registrazione audio, molti usano 24 bit perché, ancora una volta, ritengono che i bit aggiuntivi offrano una fedeltà superiore.
Alcuni programmi e registratori hardware possono persino registrare dati audio come numeri in virgola mobile a 32 bit, tuttavia, il numero di bit utilizzati per l’audio digitale non influisce sulla fedeltà, se non per stabilire il rumore di fondo, dato che la risposta in frequenza non migliora, né la distorsione viene ridotta.
Affermare che la registrazione a 24 bit sia più pulita o offra una risoluzione maggiore rispetto a quella a 16 bit non è esattamente corretto, dipende dal livello del materiale e comunque a 24 bit c’è solo più margine per la registrazione e, a mio avviso, il motivo principale per usare 24 bit è perché permette di essere meno attenti quando si impostano i livelli di registrazione.
Nota sulla Profondità in bit
Per motivi di efficienza, i percorsi dati e i chip di memoria memorizzano i dati in multipli di 8 bit.
Questa organizzazione è estesa ai dischi rigidi, ai flussi di dati in tempo reale e alla maggior parte degli altri luoghi in cui vengono utilizzati dati digitali, dunque è questo il motivo per cui anche i dati audio vengono memorizzati in multipli di 8 bit, come 16 o 24.
È possibile memorizzare l’audio con 19 bit per campione, ma ciò lascerebbe 5 bit di dati inutilizzati in ogni posizione di memoria, il che è uno spreco.
È possibile memorizzare un numero dispari di bit in modo che alcuni bit si riversino nelle posizioni di memoria adiacenti, ma ciò richiede più codice informatico da implementare, poiché i campioni parziali vengono suddivisi per l’archiviazione, quindi raccolti e ricombinati in seguito, il che a sua volta richiede più tempo per memorizzare e recuperare ogni campione.
Un’altra notazione numerica comune nei computer è quella esadecimale, spesso abbreviata in esadecimale che è simile a un sistema binario in base 2, ma i numeri sono più gestibili dagli esseri umani rispetto a una lunga stringa di cifre binarie. Con la notazione esadecimale, ogni cifra contiene un numero compreso tra 0 e 15, per un totale di 16 valori.
Errore di quantizzazione
La maggior parte dei convertitori A/D/A gestisce solo numeri interi. Se la tensione di ingresso è compresa tra due numeri interi durante il campionamento, viene memorizzata come il numero intero disponibile più vicino. Questo processo è noto come quantizzazione, ma viene anche chiamato arrotondamento perché la tensione viene arrotondata per eccesso o per difetto al valore intero disponibile più vicino.
 Quando i numeri campionati non corrispondono esattamente alla tensione in ingresso, la forma d’onda audio viene leggermente alterata e il risultato è una piccola distorsione aggiuntiva. In un sistema a 16 bit, la disparità tra la tensione effettiva e il numero intero disponibile più vicino è molto piccola. Nella maggior parte dei casi, la differenza non avrà importanza, a meno che la tensione in ingresso non sia estremamente bassa. Quando si registra a 24 bit, la disparità tra la tensione in ingresso e il valore numerico del campione memorizzato è ancora più piccola e meno significativa.
Sotto, potete sperimentare con la “digitalizzazione” di un segnale audio e i Bit Depth.
Quello in azzurro è il segnale originale, se volete vedere gli effetti della digitalizzazione, attivate il pulsante “Segnale digitalizzato” e verrà mostrato in arancio il segnale.
Scorrendo il cursore si cambia il “Bit Depth” e si vede l’effetto sulla forma d’onda digitalizzata in arancio.
Sono stati inseriti altri due pulsanti, il Dither, utilizzato per minimizzare l’errore di “troncamento” dei bit (vederete più avanti) e il Noise Shaping, utilizzato spesso in combinazione con il Dither, che serve a minimizzare l’errore di quantizzazione aggiungendo un sottile rumore bianco prima del processo di quantizzazione.
Gli effetti si possono anche sentire premendo l’icona dell’altoparlante.
TOP
Aliasing
Se all’interno del segnale analogico ci sono frequenze che si avvicinano alla metà di quella di campionamento, per la legge di Nyquist avviene uno spiacevole fenomeno chiamato Aliasing che produce “nuove” frequenze che non esistevano prima della conversione e quindi a tutti gli effetti è una “distorsione”.
Quindi, in parole povere, se la nostra frequenza di campionamento è di 44.100Hz, non possiamo andare oltre i 22.000Hz con il nostro segnale altrimenti ci saranno armoniche che potrebbero sicuramente “sentirsi” anche a frequenze udibili, per far questo serve un filtro ad alta pendenza che elimini qualsiasi cosa al di sopra dei 20.000Hz!
Sperimentare l’Aliasing
Dalle parole alla pratica… L’Aliasing oggigiorno non è più un problema (più avanti vedrete il perchè) ma sapere cosa è schiarisce alcuni dubbi.
Sotto una applicazione interattiva che mostra il fenomeno dell’aliasing
TOP
FFT – Fast Fourier Transform in tempo reale ed esperienze sui segnali
La FFT, Fast Fourier Transform, lavora nei due sensi, viene utilizzata per scomporre il segnale per poterlo analizzare oppure si può fare l’opposto, utilizzare le componenti separate e la FFT per ricomporre un segnale. Negli anni 80 il Fairlight CMI (un articolo completo in questo sito) sfruttava questo algoritmo che all’epoca era fantascienza, oggi anche un orologio da polso è in grado di eseguire una FFT.
L’applicazione sotto prevede diverse cose, si possono verificare diverse teorie della FFT cambiando componenti e “fasi” (la FFT prevede anche questo)
L’applicativo sopra è una versione “accademica” della FFT a scopi dimostrativi ma sono stati aggiunti anche altri effetti come la “digitalizzazione” per verificare con le proprie orecchie gli effetti.
La sorgente di emissione è molteplice e l’applicativo serve anche a valutare le varie forme d’onda mostrate in precedenza.
Buon divertimento!
Jitter
Un artefatto spesso citato come dannoso per la chiarezza audio è il jitter, un errore di temporizzazione specifico dell’audio digitale. Ormai sapete che una volta campionato e reso digitale, i dati dell’audio viaggiano a gruppi di 8/16/24 Bit su dei vagoni di un “trenino” virtuale (chiamato Clock o Frequenza di campionamento) fino all’uscita del convertitore digitale analogico (e subito dopo andà filtrato), se per qualsiasi motivo il “trenino” subisce rallentamenti si ottiene uno sfasamento di dati chiamato appunto “Jitter” che viene percepito come una fastidiosa distorsione. La frequenza di campionamento per l’audio di qualità CD è di 44,1 kHz, il che significa che 44.100 volte al secondo un nuovo campione di dati viene registrato o riprodotto dalla scheda audio. Se la frequenza di campionamento varia, si verificano artefatti simili a rumore o distorsione IM. Il vero jitter si verifica a frequenze estremamente elevate. Ad esempio, un nanosecondo di jitter equivale a una frequenza di 1 GHz (!). Oggigiorno il Jitter si verifica principalmente quando si collegano in cascata apparecchi tramite audio digitale oppure si utilizza un Word Clock esterno in studi di registrazione principalmente.
Jitter
Un artefatto spesso citato come dannoso per la chiarezza audio è il jitter, un errore di temporizzazione specifico dell’audio digitale. Ormai sapete che una volta campionato e reso digitale, i dati dell’audio viaggiano a gruppi di 8/16/24 Bit su dei vagoni di un “trenino” virtuale (chiamato Clock o Frequenza di campionamento) fino all’uscita del convertitore digitale analogico (e subito dopo andà filtrato), se per qualsiasi motivo il “trenino” subisce rallentamenti si ottiene uno sfasamento di dati chiamato appunto “Jitter” che viene percepito come una fastidiosa distorsione. La frequenza di campionamento per l’audio di qualità CD è di 44,1 kHz, il che significa che 44.100 volte al secondo un nuovo campione di dati viene registrato o riprodotto dalla scheda audio. Se la frequenza di campionamento varia, si verificano artefatti simili a rumore o distorsione IM. Il vero jitter si verifica a frequenze estremamente elevate. Ad esempio, un nanosecondo di jitter equivale a una frequenza di 1 GHz (!). Oggigiorno il Jitter si verifica principalmente quando si collegano in cascata apparecchi tramite audio digitale oppure si utilizza un Word Clock esterno in studi di registrazione principalmente.
Troncamento
Allo stesso modo, un artefatto chiamato distorsione di troncamento si verifica quando si riducono i file audio da 24 bit a 16 bit se non viene applicato il dithering, e alcuni ritengono che anche questo possa influire su aspetti come la pienezza e l’immagine stereo. A dispetto di quello che si pensa, passando da un file a 24 bit a uno inferiore non c’è nessuna operazione particolare, si crea un “troncamento netto” dei bit più bassi che ovviamente riduce la risoluzione. E’ sicuramente una operazione distruttiva ma non particolarmente dannosa in quanto la si può notare solo ai bassi livelli di segnale, ad esempio sulle code di un brano. Per ovviare a questo, quando si troncano i bit di un brano audio è buona regola inserire un apposito “dither”, un rumore a bassissimo livello (assolutamente inudibile) che evita che la mancanza di bit in basso faccia degli effetti collaterali indesiderati che si presentano come delle leggere distorsioni.
PCM e DSD
Fino a questo momento abbiamo parlato di un solo tipo di Audio Digitale che è una invenzione degli anni 70/80 di un consorzio di ditte a cui fanno capo Philips e Sony, ovvero, Pulse Code Modulation o Modulazione a Codice di Impulso, in breve PCM, ma ne esiste un’altra sempre sviluppata da uno dei due partner originali, ovvero Sony, e chiamata Direct Stream Digital, DSD o anche SACD (da Super audio cd).
Con il DSD, invece di convertire periodicamente una tensione variabile in numeri equivalenti a 16 o 24 bit, una tecnica nota come modulazione delta-sigma produce solo un 1 o uno 0, un flusso ad alta frequenza di 1 e 0.
Nel linguaggio matematico dell’ingegneria, la lettera greca delta esprime una variazione, o differenza, e sigma significa sommatoria, quindi delta-sigma implica una somma di differenze, che in questo caso è il flusso di differenze di uno e zero che esprime come l’audio cambia nel tempo.
I sostenitori del DSD sostengono che il campionamento delta-sigma offre una larghezza di banda più ampia (100 kHz per i dischi SACD) e un rumore di fondo inferiore rispetto alla codifica PCM standard, e l’altissima frequenza di campionamento evita la necessità di filtri di ingresso e uscita, tuttavia, il rumore dell’audio DSD aumenta drasticamente a frequenze superiori a 20 kHz, quindi i filtri sono effettivamente necessari per impedire che il rumore inquini l’uscita analogica o che aumenti la distorsione IM o danneggi i tweeter.
I filtri devono anche essere sufficientemente incisivi da sopprimere il rumore senza influenzare la banda udibile e questo è uno dei motivi per cui questo sistema non è mai realmente decollato ma il motivo principale (a parte la fine di CD e DVD) è sicuramente il non interesse nei produttori di apparecchiature professionali per la registrazione di usare questa tecnica che avrebbe solo aumentato la richiesta di risorse in maniera esorbitante.
Sistemi di compressione sonora CODEC
L’audio digitale è fatto di numeri, va da se che ad un certo punto qualcuno ha avuto l’idea di “comprimere” questi dati per risparmiare spazio e sono nati i vari encoder di compressione tanto popolari (vedi mp3) quanto dannosi anche se non certo per colpa loro ma sicuramente della ottusità delle case discografiche che dapprima non hanno capito fin dall’inizio la pericolosità e hanno delegato lo streaming a pura “moda”, poi, a danno fatto, hanno cercato di recuperare i soldi buttati vendendo pacchetti di centinaia di brani a i vari servizi di stream.
I codec di compressione si dividono in due categorie:
- Codec Lossy – La compressione degenera il suono (dal 60% al 95% di compressione)
- AAC (Advanced Audio Coding) – E’ uno standard tra i servizi di stream come Youtube, Apple Music ed è superiore ad MP3 a parità di bitrate ma comunque molto degenerativo.
- MP3 (MPEG 1 – Audio Layer III) – Il primo tra i codec e il più universale ma fortemente degenerativo e meno efficente
- OGG – Vorbis – Molto degenerativo ma molto compatto e senza brevetti. La variante MOGG è usata per il multicanale anche se NON ufficialmente
- OPUS – Molto efficente, altissima qualità ma non troppo diffuso dato che sono pochi i DAW che lo includono, molto usato in telefonia internet (VoIP), ha diversi settaggi ma il difetto principale è che sembra ottimizzato per i 48Khz per cui c’è sempre una conversione di sample rate se non utilizzate specificatamente i 48Khz. Il codec può lavorare a 8/16/24 bit PCM, la frequenza di campionamento è “fissa” a 48Khz e il bitrate è deciso da voi, già a 128Kb/s le prestazioni sono nettamente superiori ad AAC, MP3 e OGG
- WMA (Windows Media Audio) – Formato proprietario di Microsoft, poco usato
- Codec Loseless – Senza degenerazione del suono (dal 30% al 50% di compressione)
- FLAC (Free Loseless Audio Codec) – Alta risoluzione e open-source, usa la codifica MS per ridurre il file. Ha diversi settaggi ma inutili perchè lavorano all’incontrario dato che non è lossy, più si aumenta la qualità, più diventa piccolo il file
- ALAC (Apple Loseless Audio Codec) – La Apple come al solito reinventa inutilmente la ruota prendendo il FLAC e cambiando qualche virgola per renderlo proprietario… Bah.
Il fattore fondamentale per i CODEC è il “bitrate” dato che in origine sono stati pensati per lo streaming. Il bitrate è indicato in Kb/sec, più è alto, migliore è l’audio, più è basso, migliore l’efficenza. OPUS permette di usare bassi bitrate ma qualità nettamente superiore ad MP3 a scapito della “decodifica”, ovvero il tempo che serve al computer per ricostruire l’audio originale ma oggi qualsiasi cellulare o computer è in grado di farlo senza il minimo sforzo.
TEST di compressione
Per capire meglio i CODEC ho fatto una serie di test che mostro qui sotto:
Il riferimento è un brano in WAV, il primo della fila, non è stato inserito in lista il codec Apple perchè è esattamente uguale al FLAC e il WMA perchè inutilizzato da quasi tutti
| CODEC | Estensione | Bitrate | Dimensioni |
 | .wav | no | 5.647Kb |
 | .opus | 64Kb/s | 175Kb |
| .opus | 128Kb/s | 348Kb |
| .opus | 192Kb/s | 520kb |
| .opus | 320Kb/s | 1376Kb |
 | .flac | no | 4361Kb |
 | .mp3 | 140-170Kb/s | 463Kb |
| .mp3 | 170-210Kb/s | 556Kb |
| .mp3 | 220-260Kb/s | 728Kb |
| .mp3 | 320Kb/s | 857Kb |
 | .m4a | 112Kb/s | 552Kb |
| .m4a | 192Kb/s | 552Kb |
| .m4a | 256Kb/s | 724Kb |
| .m4a | 320Kb/s | 901Kb |
 | .ogg | Level 1 | 228Kb |
| .ogg | Level 5 | 464Kb |
| .ogg | Level 10 | 1300Kb |
ASCOLTO
Riferimento WAV
FLAC
AAC
MP3
OGG
OPUS
Gli effetti collaterali
Mp3, AAC e OGG deteriorano l’audio con qualsiasi settaggio, in particolare MP3 usa una sorta di FFT (vista prima, Fas Fourier Transform) e comprime il risultato serialmente senza rispettare lo stereo in quanto nella fase di codifica si tratta solo di numeri in sequenza, una parte delle informazioni stereo rimbalzano a destra e sinistra e in particolare le parti molto basse, notorialmente problematiche per la FFT, diminuiscono parecchio l’efficenza.
OGG è nato per essere una alternativa più efficente ma non certo meglio qualitativamente, AAC è nato per lo streaming e non ha certo ideali qualitativi, solo più efficente e meno esigente in decodifica.
Come si è detto sopra, il parametro principale dei codec lossy è il bitrate che negli anni è diventato anche “variabile”, ovvero, il codec decide in base ad un input da parte dell’utente se deve utilizzare quello fisso o adattarsi alla bisogna.
Nel caso MP3 sicuramente il bitrate variabile è migliore ma è pur vero che alcuni codec come OGG e AAC hanno questo parametro “blindato” internamente, l’unico ad averlo disponibile è OPUS che è il più nuovo tra i codec e sicuramente il migliore tra i lossy oltre che il più efficente.
Sotto, nelle diverse playlist questa volta sono registrati solo gli “artifacts” (i difetti) dei rispettivi codec a diversi bitrate, noterete che più si va in alto e meno sono presenti ma il fatto che si sentano a qualsiasi settaggio da l’idea del valore aggiunto non certo esaltante di questi codec, solo OPUS vince su tutti anche se non è molto popolare tra i DAW
DIFETTI di codifica
Quello che sentite sono SOLO i difetti della codifica, la procedura è semplice, una semplice operazione matematica dove l’originale viene sommato alla “controfase” della sua versione compressa.
Se fosse “loseless” non si sentirebbe nulla ma dato che questi codec sono “lossy” c’è una differenza ed è quella che sentite sotto.
AAC
AAC si dimostra molto simile ad MP3 nonostante molti dicano l’opposto, parti dello stereo (medie e alte) vengono rimbalzate a destra e sinistra velocemente dichiarando la natura “streaming” e seriale del codec.
MP3
MP3 ormail lo conosciamo, difetta a qualsiasi settaggio, solo VBR a 320K (variabile) è accettabile ma anche così l’immagine stereo è falsata e le basse spesso strane.
OGG
OGG crea degli “spike” a bassi bitrate, molto alti e fastidiosi, la versione a Level 1 non è stato possibile ultilizzarla, sembra leggermente meglio dell’MP3 a patto che il bitrate sia elevato
OPUS
Una delle caratteristiche principali è che lo stereo è quasi intatto, a 64Kb/s è stranamente ascoltabile ma se ascoltate i difetti sono molto evidenti, guardando la forma d’onda si vedono scalini digitali ovunque ed è inevitabile dato la misera quantità di dati, il povero codec se ne deve inventare molto più della metà! Al massimo delle impostazioni è quasi perfetto, assolutamente impercettibile!
Conclusioni
Vista l’evoluzione delle CPU e la potenza dei telefonini, il miglior codec tra i lossy è sicuramente OPUS, seguito da OGG (che tra l’altro è totalmente open-source). La maggior parte dei cellulari digerisce senza problema OPUS, Firefox lo incorpora da almeno 10 anni, i vecchi computer potrebbero avere problemi.
MP3 è talmente diffuso che è universale ma tra i codec è il peggiore assieme ad AAC (che è un mp3 ricarrozzato, in stile Apple, come al solito), lo usano le radio locali.
FLAC è ottimo ed è loseless ma la sua compressione è molto limitata, una media del 45% se va bene.
L’equivalente Apple è identico, il motivo di un altro nome è quello di inserire dati Apple all’interno come l’inutile copyright (aggirabile purtroppo)
La parte dolente, lo streaming e i codec
Lo streaming è nato tanto tempo fa, nel 1993, ma a livello sperimentale, RealNetworks (presente ancora oggi) lo usò per lanciare questa tecnologia, ma fu uno sviluppatore indipendente che guardando dentro il CD semestrale che Microsoft dava agli sviluppatori “gratis”, trovò un cartella chiamata mp3 encode/decode, un esperimento che la casa di Bill Gates (che allora denigrava internet definendola “fenomeno passeggero”) aveva scartato ritenendolo inutile, nel 1999 lanciò la sua applicazione free chiamata “Napster” che usava il protocollo Peer-to-Peer e l’archiviazione dei file in mp3, divenne talmente famoso in soli due anni che alla sua chiusura nel 2001 aprì la strada al mondo sharing e la musica non fu più la stessa, iniziò il collezionismo da parte degli utenti dato che “nulla è meglio del gratis” e gli hard disk si riempirono come non mai di musica ma senza che nessuno pagasse nulla.
Le case discografiche, ignoranti come capre ed alcune con a capo costruttori di lettori mp3(!), non faccio nomi, non capirono il problema e usarono il vecchio sistema delle denunce, senza alcuna contromossa e il risultato lo vediamo oggi, un intero “mondo” che sopravvive con il vecchio sistema quasi medioevale di andare a suonare davanti alle persone e regalare allo streaming il prodotto delle sue fatiche…
Copyright 2022-2026 ostiglia.art & sumotoy Tutte le immagini elaborate sono di proprietà di ostiglia.art tranne dove indicato, in tal caso la proprietà è dell’autore, i contenuti sono esclusiva di ostiglia.art e Max MC Costa. Vietata la duplicazione anche in parte dei contenuti, o la ripubblicazione. E’ consentito lo sharing tramite i tasti forniti oppure attraverso la pubblicazione del link originale. Per altre richieste, contattateci attraverso il Form
s: 0 su 10